音色配置
挑一个你愿意长期听的声音
语音合成(TTS)
主要用于为系统提供拟人化语音播报与实时语音输出能力。
1. 应用场景
- 消息自动朗读:聊天消息文本转语音自动播报。
- 语音交互全流程:语音唤醒回复、实时语音通话、伴睡模式等场景的语音发声。
2. 操作路径
设置 → 模型配置 → 语音合成模型
3. 支持的服务商
目前灵枢已接入并支持以下语音服务商与协议标准:
- 阿里云 (Aliyun TTS)
- 小米 (Xiaomi)
- 火山引擎 (Volcengine / 字节跳动)
- Fish Audio
- 灵枢 Fish 兼容协议(支持自建或兼容 Fish 协议的服务接入)
[!TIP] 前往对应服务商开放平台获取 API Key / Token 后,在配置页选择对应服务商并填入凭证即可生效。
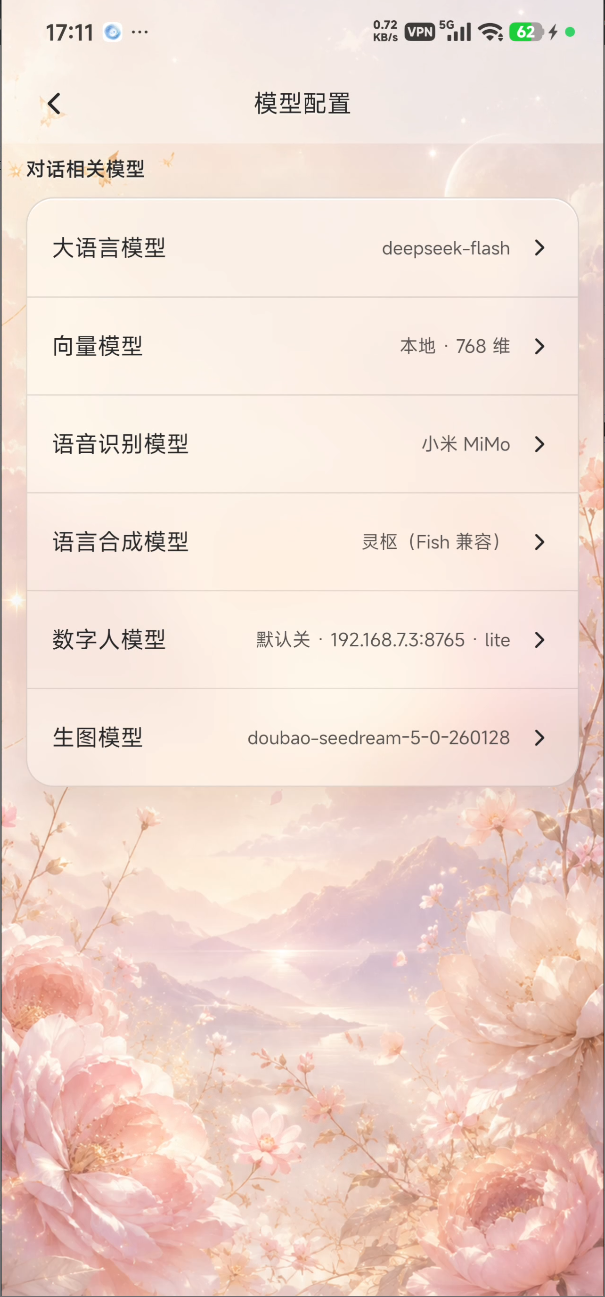
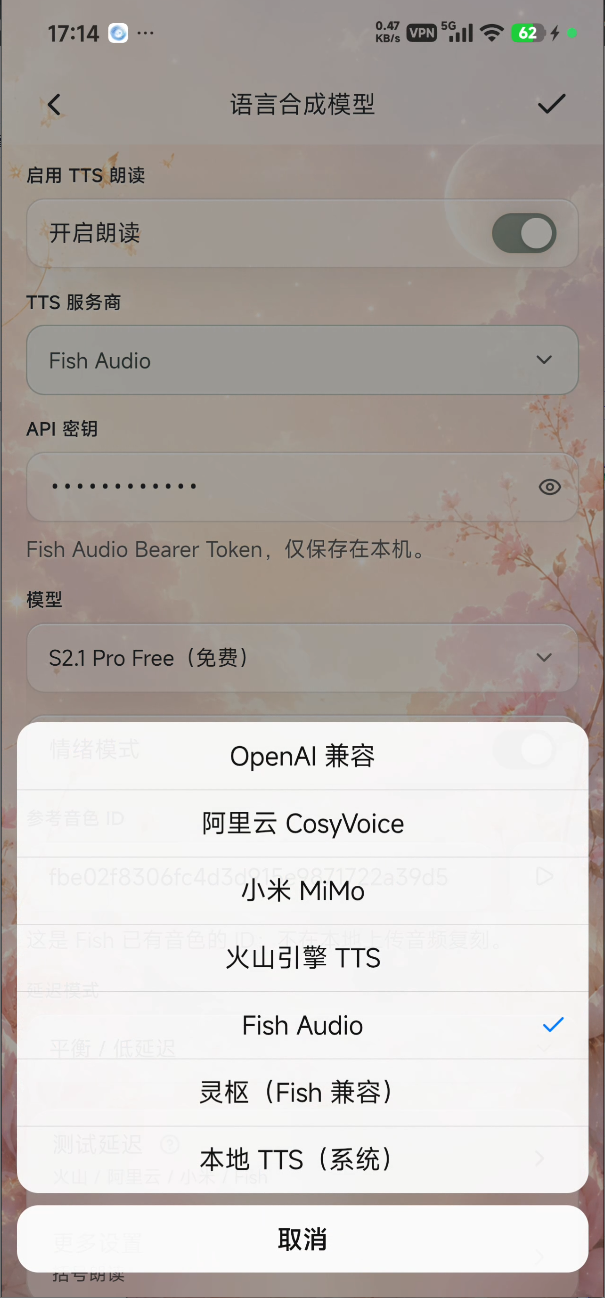
接下来依次介绍如何配置
小米 MiMo TTS 配置指引(免费)
小米 MiMo 语音合成目前处于免费阶段,且注册流程极简(暂无需实名认证),推荐优先接入体验。
1. 获取 API Key 步骤
- 注册与登录:
- 访问官网注册账号:小米 MiMo 官网
- 创建密钥:
- 登录成功后,直接访问 API 密钥管理页
- 点击 创建 API Key 并完成复制。
2. 系统中配置
- 返回系统:
设置→模型配置→语音合成模型 - 服务商选择 小米 / MiMo
- 将复制好的密钥粘贴至 「密钥输入框」 中保存即可。
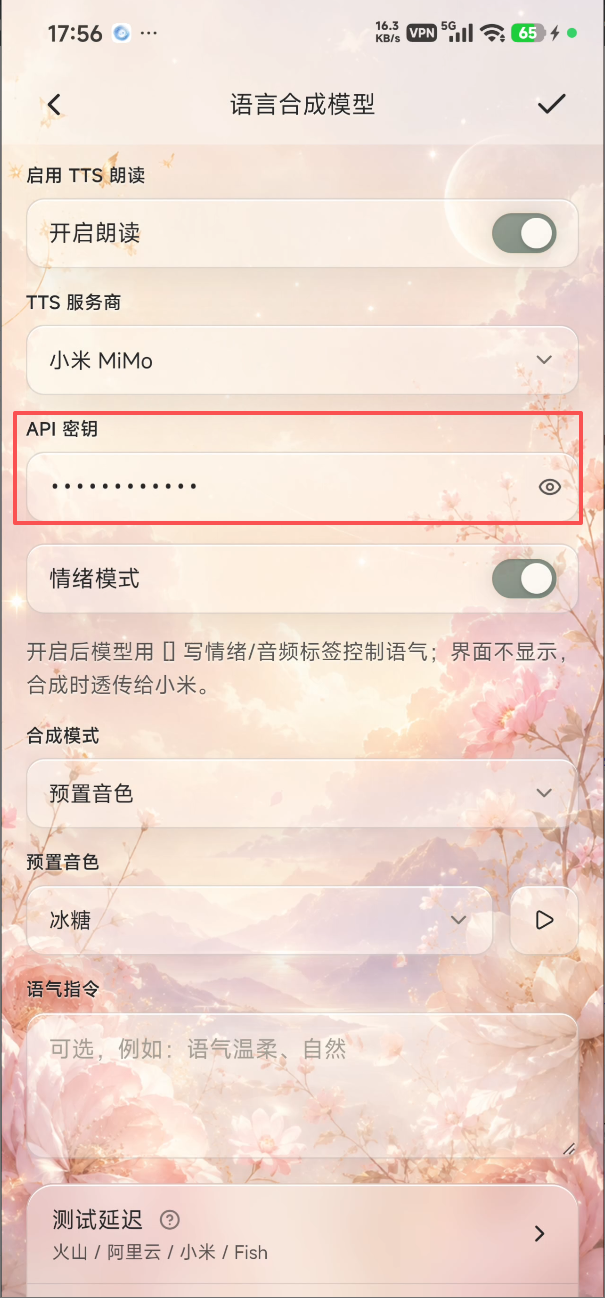
音色模式与选择建议
系统提供 预置音色 与 音色复刻(自定义声音) 两种合成模式:
| 模式 | 特点与优势 | 使用建议 / 音频要求 |
|---|---|---|
| 预置音色<br>(推荐) | ⚡ 响应速度极快、延迟低,稳定性高。 | 推荐在日常对话、实时通话等注重低延迟体验的场景下优先使用。 |
| 声音复刻 | 🎙️ 支持通过上传样本音频克隆专属音色。 | 上传音频时建议满足以下条件,以确保最佳复刻效果:<br>• 格式:支持 MP3 等常见音频格式<br>• 时长:建议音频时长 不超过 10 秒<br>• 音质:发音清晰、无背景杂音/噪点 |
[!TIP] 调优小建议:
- 追求极致的对话流畅度与首包响应时间,建议首选 预置音色;
- 复刻音色质量直接受原音频影响,录音时建议尽量贴近麦克风并处于安静环境。
火山引擎声音复刻
访问以下链接
https://console.volcengine.com/speech/new/experience/clone?projectName=default
上传参考音频
同意协议 点开始复刻
复刻完成 点击箭头的地方 复制音色id
-
模型配置——语音合成模型
-
服务商选火山引擎TTS
-
资源ID选声音复刻模型
-
音色id填写之前复制的音色id即可
-
复制API密钥 https://console.volcengine.com/speech/new/setting/apikeys?projectName=default 复制密钥粘贴到 api密钥 输入框
说明: 首次开通应该会赠送10个音色槽位(意味着同时可以用 10个 自己复刻出来的音色),2w字免费语音合成额度 每个音色槽位可训练14次音色,每次训练都会覆盖前次训练的音色 免费额度用完 可购买语音包 https://console.volcengine.com/speech/new/purchase?projectName=default官方定价 28元 10w字 合成额度
不购买也可以,开通后付费的方式 0.0003/字 RMB
阿里云声音复刻
-
访问 大模型服务平台百炼控制台 创建APIKEY 保存好(没有登录会自动跳转登录页面 登录成功后会自动跳转到APIKEY页面)
-
访问 大模型服务平台百炼控制台
-
上传音频即可完成复刻
-
复刻完成后访问 大模型服务平台百炼控制台 即可看到已经复刻的音色,点击箭头所指复制音色ID
将复制好的音色ID粘贴到灵枢语音合成模型 音色输入框右上角保存即可